Perplexity対策|AI検索の「出典」に選ばれる情報発信のコツ
「Perplexity(パープレキシティ)に、自社の情報を出典として表示させたい」——AI検索の利用が広がるなか、そんな相談が増えています。Perplexityは、回答のすぐ横に参照元(出典)のリンクを明示するタイプのAI検索エンジンです。だからこそ、GoogleのSEOとは少し違う発想で「引用されやすい情報発信」を整える価値があります。この記事では、Perplexityの仕組みから、出典に選ばれる条件、今日から着手できる具体施策、そして他のAI検索との対策の違いまでを、実務目線で整理します。
先に結論をお伝えします。Perplexity対策の要点は、(1)質問に対する「答え」を要点先出しで明確に書く (2)一次情報・数値・出典で裏づけて信頼性を高める (3)クローラー(PerplexityBot)がページを読める状態にしておく——この3つです。特別な裏技はありません。AIが「そのまま引用しやすい、信頼できる一節」を用意しておくことが、出典に選ばれる近道です。
この記事のポイント
- Perplexityは出典を明示する「リアルタイム検索型」のAI回答エンジン
- 出典に選ばれる条件は明確な記述・権威性・鮮度・構造・一次情報の5つ
- 施策は要点先出しの文章/構造化データ/サイテーション/クロール許可が柱
- 効果は「実際にPerplexityで質問して、自社が出典に出るか」で確認する
Perplexity対策とは?まず結論から
Perplexity対策とは、ユーザーがPerplexityで質問したときに、その回答の出典(ソース)として自社サイトのページが選ばれ、リンクされる状態をつくる取り組みです。これは、AI検索全体への最適化(AIO/GEO/LLMO)の一分野にあたります。AI検索対策の全体像はAI検索対策とは?AIO・GEO・LLMOの基礎で整理していますので、本記事とあわせてご覧ください。
重要なのは、Perplexityが「出典を明示する」設計だという点です。GoogleのAI Overviewsのように回答へ要約が溶け込むのではなく、Perplexityは参照した各ページを番号付きのリンクとして並べます。つまり、引用されれば自社サイトへのクリック(参照トラフィック)が生まれる可能性があります。ここがPerplexity対策に取り組む実務的なメリットです。
そもそもPerplexityとは|出典を明示するAI回答エンジン
対策を考える前に、Perplexityがどう動いているのかを押さえておきましょう。仕組みが分かれば、「なぜその施策が効くのか」が腑に落ちます。
リアルタイム検索+出典明示が最大の特徴
Perplexityは、質問を受けるとその場でWeb上の情報を検索し、関連するページから要点を抜き出して回答を組み立てます。そのうえで、根拠にしたページを出典として提示するのが大きな特徴です。学習済みデータだけで答える一般的なチャットAIと違い、最新のWeb情報を参照できるため、情報の鮮度が保たれやすく、ユーザーも出典をたどって事実確認ができます。
仕組みの土台は「検索して補強する」発想
技術的には、AIが外部の検索結果を取り込んで回答に反映させる「検索拡張」の発想が土台にあると説明されます。ざっくり言えば、「まずWebを検索し、見つかった情報を根拠に答える」流れです。だからこそ、検索で見つけてもらえること、そして見つかった先のページが「引用しやすい形」になっていることが、出典に選ばれるかどうかを左右します。
従来の検索エンジン(Google)との違い
従来のGoogle検索は、キーワードに対して「リンクの一覧」を返します。ユーザーは自分でページを開いて答えを探します。一方Perplexityは、質問に対する「答え」を要約して直接提示し、根拠を出典として添えるという流れです。ユーザーがページを一つずつ開かなくても答えにたどり着ける分、「どのページが出典に選ばれるか」の競争が、より直接的な意味を持つようになります。
Perplexityの「出典」に選ばれる5つの条件
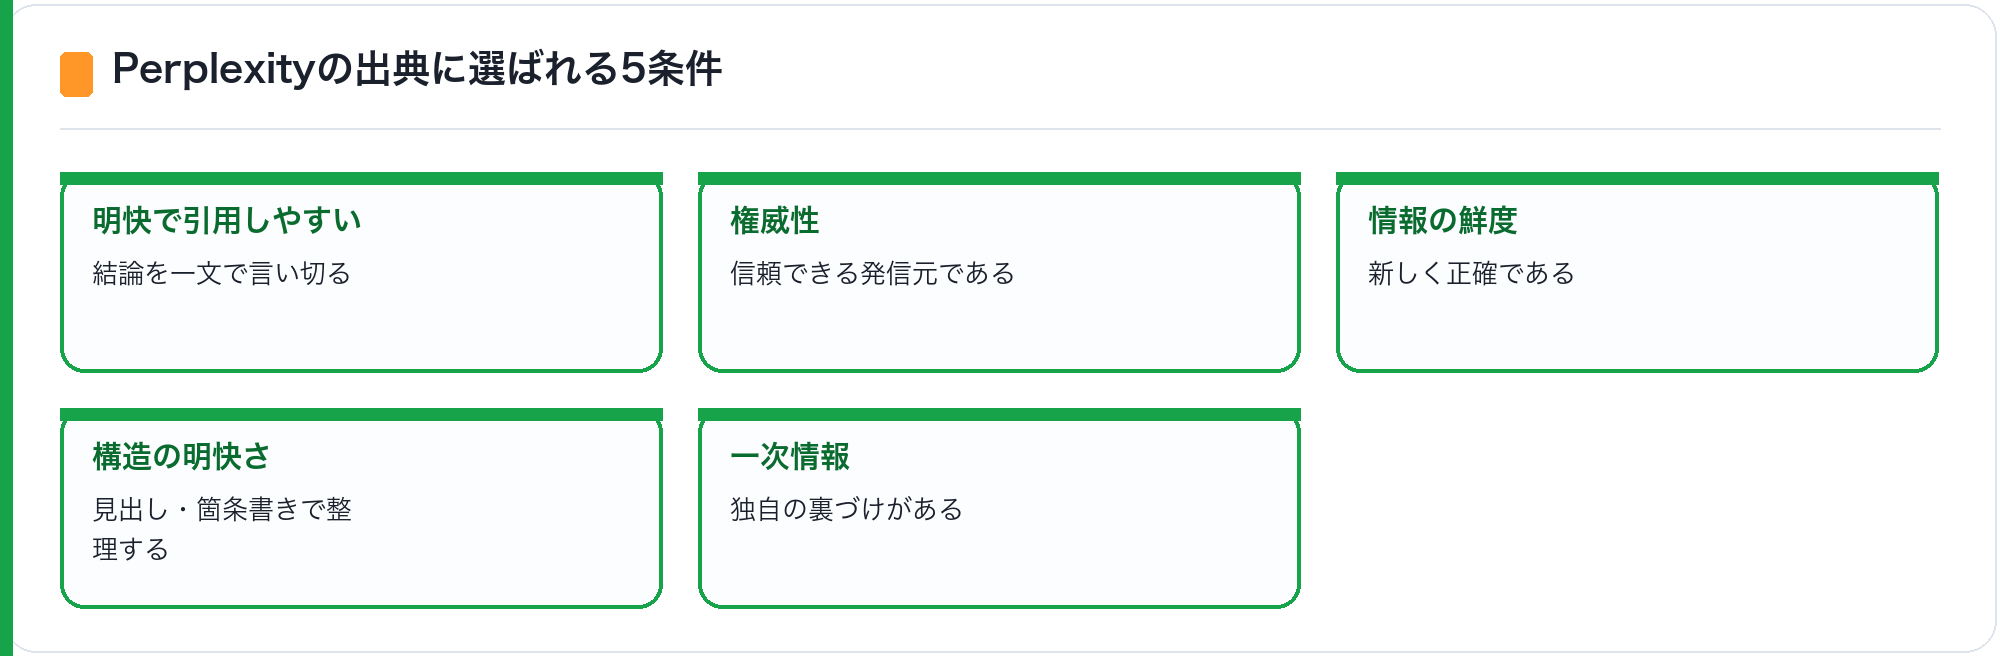
Perplexityは、出典選定の詳細なロジックを公開していません。そのため「これをやれば必ず引用される」という保証は存在しません。ただし、公開情報や各種解説、そしてSEO・E-E-A-Tの基本から、引用されやすい情報には共通した傾向が見えてきます。ここでは5つの条件に整理します。
| 条件 | 中身 | なぜ効くか |
|---|---|---|
| (1)明確さ | 結論・定義を短く言い切る | AIがそのまま抜き出しやすい |
| (2)権威性 | 発信者・専門性が明確 | 信頼できる根拠として選ばれやすい |
| (3)鮮度 | 情報・日付が新しい | リアルタイム検索と相性が良い |
| (4)構造 | 見出し・箇条書きで整理 | 該当箇所を特定しやすい |
| (5)一次情報 | 独自の調査・数値・事例 | 他にない情報源として価値が高い |
条件1:明確で引用しやすい記述になっている
AIは、質問に対する「答え」を短く抜き出せる文章を好みます。見出しや段落の冒頭に結論や定義を置き、一文で言い切ることが有効です。たとえば「〇〇とは、△△のことです」と定義を先に示す、数値や条件を具体的に書く、といった工夫です。回りくどい前置きが長い文章は、どこが答えか分かりにくく、引用されにくくなります。
条件2:発信者の権威性・信頼性が伝わる
誰が書いた情報なのかが明確で、専門性や実績が伝わるページは、信頼できる根拠として選ばれやすくなります。運営者情報(会社概要・執筆者プロフィール)、実際の取り組みに基づく一次的な知見、問い合わせ先の明示などが、信頼のシグナルになります。これはGoogleが重視するE-E-A-T(経験・専門性・権威性・信頼性)の考え方とも重なります。なお、実在しない監修者や肩書きを装うのは逆効果かつリスクなので、必ず実在する担当者・実績で示します。
条件3:情報が新しい(鮮度がある)
Perplexityはリアルタイムでの検索を前提にしているため、情報の鮮度が重視されやすいと考えられます。公開日・更新日を明記し、古くなった数値や制度の説明は定期的に見直します。「いつ時点の情報か」をページ内に書いておくことは、ユーザーにもAIにも親切です。
条件4:構造が明快で、該当箇所を特定しやすい
見出し(h2・h3)で話題が整理され、箇条書きや表でポイントがまとまっているページは、AIが「どの部分が質問の答えか」を特定しやすくなります。見出しだけを拾い読みして内容が分かる状態が理想です。1つの見出しに1つのテーマを対応させ、話を詰め込みすぎないことがコツです。
条件5:一次情報・独自データがある
他のどこにも載っていない独自の調査結果、自社の事例、具体的な数値は、AIにとって価値の高い情報源です。どこかの受け売りではなく、自社だからこそ書ける一次情報を持つことが、中長期で最も効く差別化になります。ただし、数値を出すときは必ず根拠と出典を添え、あいまいな数字を断定しないようにします。
Perplexityの出典に選ばれるための具体施策
条件が分かったら、次は実装です。ここでは「文章設計」「構造化データ」「サイテーション」「クロール許可」の4つの観点で、具体的な施策を紹介します。どれも、やりすぎや小細工ではなく、情報を正しく整えるための基本施策です。
施策1:Q&A・要点先出しの文章設計にする
最も効果的で、すぐ着手できるのが文章の書き方の見直しです。想定される質問をそのまま見出しにし、その直後に短く答える「Q&A型」や、段落の冒頭に結論を置く「要点先出し(結論ファースト)」を徹底します。ユーザーが実際にAIへ投げかける質問の言葉で見出しを作ると、質問と答えが結びつきやすくなります。
ここで役立つのが「質問タイプを意識する」という視点です。ユーザーの質問は、おおまかに事実確認(〇〇とは)・ハウツー(〇〇のやり方)・比較(AとBの違い)・意見や推奨(おすすめは)の型に分かれます。ページごとに「このページはどの質問型に答えるのか」を先に決め、その型に合った書き出しにすると、答えが明確になり引用されやすくなります。
施策2:構造化データ(schema.org)を実装する
FAQ・記事・運営者情報などに構造化データ(schema.org)を実装すると、ページの内容や発信者の情報を、機械が正確に理解しやすくなります。特にFAQPage構造化データは、質問と答えのペアを明示できるため、Q&A型の記事と相性が良い施策です。実装方法はGoogleの公式ドキュメント(Google検索セントラルの構造化データ解説)が信頼できる一次情報です。構造化データは「中身の正しい説明」であることが前提で、表示内容と異なる記述を入れるのは避けます。
施策3:サイテーション(言及・指名)を増やす
サイテーションとは、他のサイトやSNS、各種メディアで自社の名前やサービスが言及されることです。リンクの有無にかかわらず、「多くの場所で名前が挙がっている」状態は、権威性・知名度のシグナルになり得ます。プレスリリース、業界メディアへの寄稿、SNSでの発信、実績紹介などを通じて、自然に名前が挙がる機会を増やしていきます。指名検索(会社名・サービス名での検索)が増えることも、全体の信頼性につながります。
施策4:クロールを許可する(PerplexityBot・robots.txt)
見落とされがちですが、大前提としてクローラーが自社ページを読める状態になっているかを確認します。Perplexityの公式ドキュメントによると、同社はサイトを収集して検索結果に表示・リンクするためのクローラー「PerplexityBot」を運用しており、これはrobots.txtの指定に従うとされています。つまり、robots.txtでPerplexityBotをブロックしていると、出典として表示される機会を自ら閉ざすことになります。
また、公式ドキュメントでは、ユーザーが質問した際にページを取得する「Perplexity-User」という別のエージェントについても説明されています。こちらはユーザーの操作を起点とするため、robots.txtの指定を基本的に参照しないとされています。いずれにせよ、検索結果に表示されたい場合はPerplexityBotを許可しておくのが基本方針です。あわせて、AIクローラー向けにサイトの要点を示す「llms.txt」の設置や、robots.txtでのAIクローラー許可の整理も、AI検索対策全体として検討する価値があります。
他のAI検索との対策の共通点・相違点【比較表】
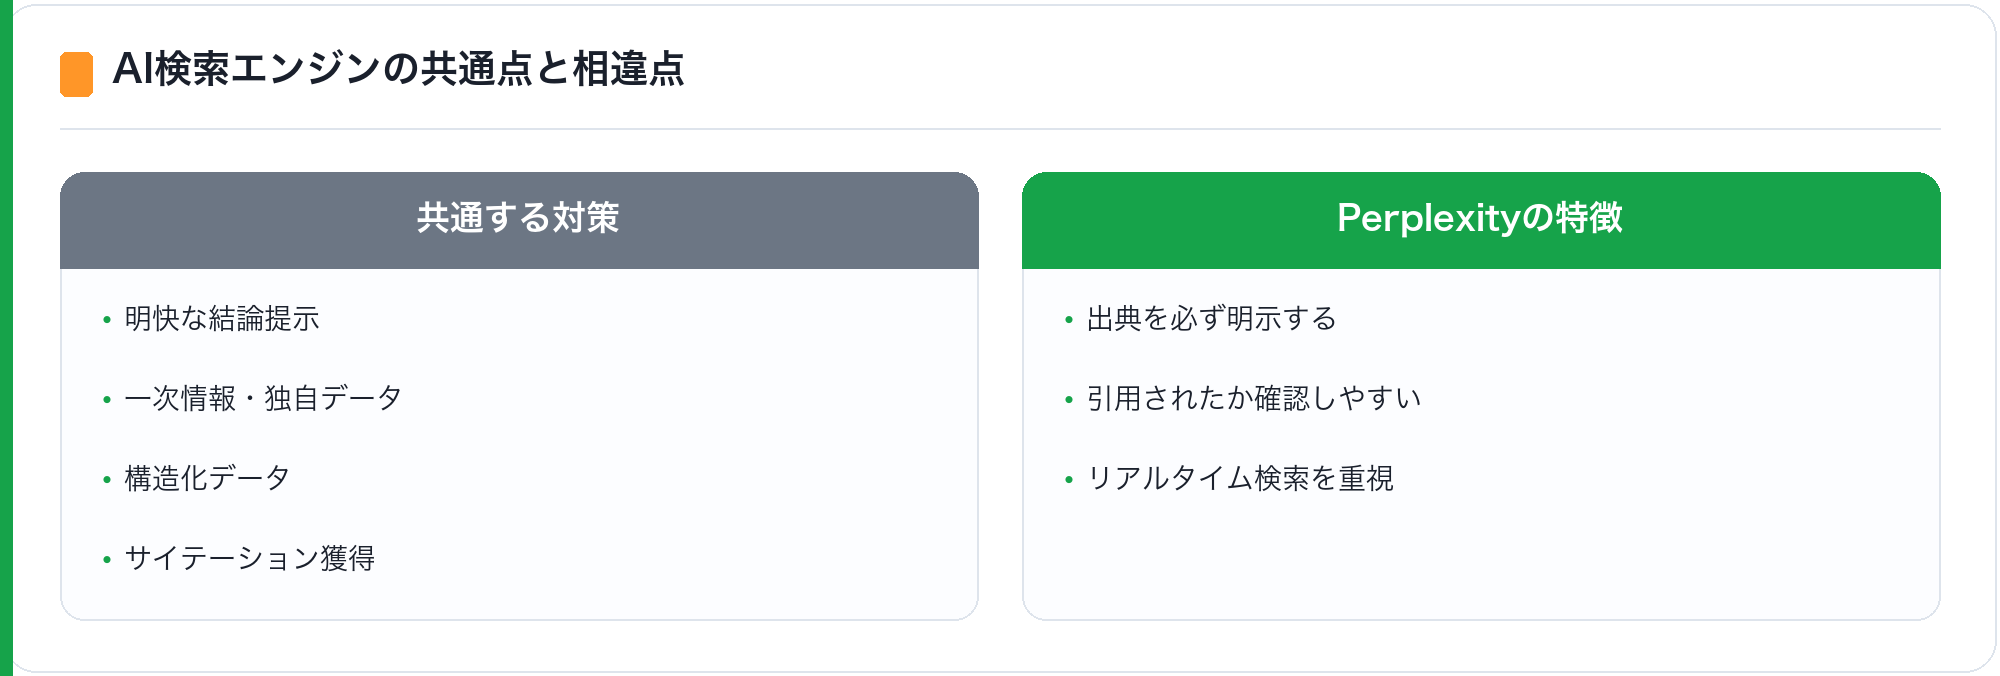
Perplexityだけを見ていると、対策が偏ります。実際には、ChatGPTの検索機能やGoogleのAI Overviewsなど、複数のAI検索が併存しています。ここでは主要なAI検索ごとに、最適化のポイントがどう違うかを比較表にまとめます。これが本記事の独自の切り口です。
| 観点 | Perplexity | ChatGPT(検索) | Google AI Overviews |
|---|---|---|---|
| 出典の見え方 | 番号付きで明確に提示 | 脚注的に控えめ | 回答下にリンク |
| 情報の取得 | リアルタイム検索重視 | 検索+学習データ | Google検索が基盤 |
| 従来SEOの影響 | 中(独自基準の面も) | 中 | 大 |
| 効きやすい施策 | 要点先出し・鮮度・一次情報 | 権威性・知名度・言及 | 従来SEO+E-E-A-T |
| 詳しい対策 | 本記事 | ChatGPT表示対策 | AI Overviews対策 |
※上記は各サービスの公開情報や一般的な解説から整理した傾向であり、各社が内部ロジックを公開しているわけではありません。仕様は変化するため、方向性の目安としてご覧ください。
共通点:どのAI検索でも効く「土台」は同じ
エンジンによる違いはありますが、共通して効く土台があります。(1)質問に明確に答える要点先出しの文章、(2)発信者の権威性と信頼性(E-E-A-T)、(3)独自の一次情報、(4)クローラーが読める技術的な状態——この4つは、どのAI検索を狙う場合でも外せません。言い換えれば、小手先の最適化よりも「読者にとって役立つ、信頼できる情報を、分かりやすく整える」という本質が共通のベースです。
相違点:Perplexityは「鮮度」と「要点の明快さ」が特に効く
一方で、重心は少しずつ異なります。Google AI Overviewsは、Google検索が基盤になるため従来SEOの影響が大きい傾向です。ChatGPTの検索は、ブランドの知名度や各所での言及が効きやすいと言われます。これらに対しPerplexityは、リアルタイム検索を前提とするため「情報の鮮度」と「要点の明快さ」が特に活きやすいのが特徴です。まずPerplexity向けに要点を整え、そこへGoogle向けのE-E-A-Tや従来SEOを重ねていく、という順番が現実的です。
効果の確認方法|実際にPerplexityで質問してみる
AI検索対策は、従来のSEOのように順位ツールで一律に測りにくい面があります。そこで基本になるのが、「実際にPerplexityで質問して、自社が出典に出てくるか」を自分で確かめるという地道な方法です。
主要な質問を一覧にして、定点観測する
自社の商品・サービスに関連して、見込み客が実際に投げかけそうな質問を10〜20個リストアップします。それをPerplexityで順番に質問し、(1)自社が出典に表示されるか (2)回答の内容が自社の主張と合っているか (3)どのページが引用されているかを記録します。これを定期的に繰り返せば、施策の効果や変化を把握できます。
競合がなぜ引用されているかを分析する
自社が出典に出ず、競合や他メディアが出ている場合は、その引用元ページを開いて「なぜ選ばれたのか」を分析します。見出しの付け方、結論の示し方、数値や一次情報の有無、構造の分かりやすさ——こうした点を自社ページと見比べ、足りない要素を補強します。引用されている実例こそ、最良のお手本です。
参照トラフィックの変化も合わせて見る
出典に選ばれてリンクされれば、そこからの流入(参照トラフィック)が生まれる可能性があります。アクセス解析で、AI検索サービスからの流入が増えているかを継続的に確認します。ただし、AI経由の流入は計測が完全ではない場合もあるため、質問テストと合わせて総合的に判断するのが現実的です。
Perplexity対策でやりがちな失敗と注意点
最後に、よかれと思ってやると逆効果になりやすい落とし穴を挙げておきます。基本は「ユーザーに誠実な情報発信」から外れないことです。
根拠のない数値や成果を書いてしまう
引用されたいあまり、根拠のない数値や過剰な成果表現を書くのは避けます。出典を確認できないデータや断定的な数字は、信頼性を損ない、かえって選ばれにくくなります。数値を出すときは必ず一次情報の出典を添え、不確かなことは「〜とされています」と範囲を明示します。
AI向けの小細工に走る
ユーザーに見えない隠しテキストや、中身の薄いページの量産といった小細工は、長期的にはマイナスです。AI検索の評価も、最終的には「人にとって役立つか」に収束していきます。地に足のついた一次情報と、分かりやすい構造の積み重ねが、結局いちばん強い対策です。
Perplexityだけを見て全体を見失う
Perplexityは重要なAI検索の一つですが、対策はそれ単体で完結するものではありません。前述の比較表のとおり、共通の土台を固めたうえで各エンジンの差分を補うのが効率的です。AI検索対策の全体設計を軸に進めると、個別エンジンへの対応に偏らず、施策の抜け漏れを防げます。限られたリソースのなかで優先順位をつけるためにも、まず全体像を描いてから、効果を確認しやすいPerplexityのような出典明示型から着手するのが現実的です。
今日から始めるPerplexity対策の進め方【実践ステップ】
条件と施策を理解したら、あとは順番に手を動かすだけです。いきなり全てをやろうとすると挫折しやすいので、効果が出やすく、負担の軽いものから順に着手するのがおすすめです。ここでは現実的な5ステップに整理します。
ステップ1:想定質問を洗い出し、優先ページを決める
最初に、見込み客がPerplexityで投げかけそうな質問を書き出します。商品名での質問、悩みベースの質問、比較の質問などを幅広く集め、そのなかで「自社が答えられる・答えるべき」質問を選びます。そのうえで、どのページ(既存記事やサービスページ)がその質問に対応するのかを紐づけ、改善の優先順位を決めます。手を広げすぎず、まずは主要な数ページに絞るのがコツです。
ステップ2:優先ページを「要点先出し」に書き直す
選んだページの冒頭に、質問に対する結論や定義を短く置きます。見出しも、ユーザーが実際に使う質問の言葉に寄せて付け直します。前置きが長く答えが埋もれている段落は、結論を先頭に移動させるだけでも、AIが答えを抜き出しやすくなります。文章全体を作り直す必要はなく、「冒頭と見出しの手直し」から始めると負担が軽く済みます。
ステップ3:一次情報と出典を足す
次に、そのページに自社ならではの一次情報を加えます。実際の事例、取り組みで得た気づき、独自の視点での整理などです。外部データを使う場合は、必ず信頼できる出典(公式情報や一次調査)を明記します。あいまいな数字を断定で書かず、根拠とセットで示すことが、信頼性と引用されやすさの両方を高めます。
ステップ4:構造化データとクロール設定を整える
技術面では、FAQや運営者情報などに構造化データを実装し、robots.txtでPerplexityBotがブロックされていないかを確認します。あわせて、公開日・更新日の表示や、運営者情報ページの整備など、信頼性が伝わる基本要素もチェックします。これらは一度整えれば効果が持続する「土台」の施策です。
ステップ5:Perplexityで検索し、結果を見て直す
最後に、ステップ1で洗い出した質問を実際にPerplexityで検索し、自社が出典に出るかを確認します。出ていなければ、引用されている競合ページと自社ページを見比べ、足りない要素を補強します。「出して終わり」ではなく、確認して直すというサイクルを回すことが、AI検索対策では特に重要です。この検証重視の進め方は、広告やLPの改善とも共通する考え方です。
まとめ:Perplexity対策は「引用しやすい一次情報」を整えること
Perplexityは、出典を明示するリアルタイム検索型のAI回答エンジンです。その出典に選ばれるために必要なのは、特別な裏技ではなく、質問に明確に答える要点先出しの文章・権威性・鮮度・明快な構造・独自の一次情報という、情報発信の王道を丁寧に整えることでした。あわせて、構造化データの実装、サイテーションの獲得、そしてPerplexityBotを許可するクロール設定を押さえれば、土台は整います。まずは主要な質問でPerplexityに検索し、自社が出典に出るかを確かめるところから始めてみてください。
※本記事は一般的な解説であり、特定の表示・引用や成果を保証するものではありません。各AI検索サービスの仕様やロジックは変化します。最新かつ正確な仕様は各社の公式情報(Perplexity公式のボットガイド、Google検索セントラル等)をご確認ください。
よくある質問
Q. Perplexity対策をすれば、必ず出典に表示されますか?
A. いいえ、必ず表示される保証はありません。Perplexityは出典選定の詳細なロジックを公開しておらず、確実に引用させる方法は存在しません。できるのは、要点先出しの明確な記述・一次情報・権威性・鮮度・明快な構造を整え、クローラーが読める状態にして、引用されやすい確率を高めることです。
Q. PerplexityとGoogleのSEO対策は何が違いますか?
A. 土台は共通しています。ただしGoogle AI Overviewsは従来SEOの影響が大きい一方、Perplexityはリアルタイム検索が前提のため「情報の鮮度」と「要点の明快さ」が特に活きやすい傾向があります。まずPerplexity向けに要点を整え、Google向けのE-E-A-Tや従来SEOを重ねる順番が現実的です。
Q. PerplexityBotはブロックしないほうがいいですか?
A. 検索結果に表示されたい場合は、許可しておくのが基本です。Perplexityの公式ドキュメントによると、PerplexityBotはサイトを収集して検索結果に表示・リンクするためのクローラーで、robots.txtの指定に従うとされています。robots.txtでブロックしていると、出典として表示される機会を自ら閉ざすことになります。
Q. 構造化データは実装したほうがいいですか?
A. おすすめします。FAQや記事、運営者情報に構造化データ(schema.org)を実装すると、ページの内容や発信者情報を機械が正確に理解しやすくなります。特にFAQPage構造化データはQ&A型の記事と相性が良い施策です。実装方法はGoogle検索セントラルの公式ドキュメントが信頼できる一次情報です。
Q. 効果はどうやって確認すればいいですか?
A. 見込み客が投げかけそうな質問を10〜20個リスト化し、実際にPerplexityで質問して、自社が出典に出るか・内容が合っているか・どのページが引用されているかを記録します。これを定期的に繰り返し、競合の引用元も分析して、足りない要素を補強するのが基本です。
Q. 一次情報がない場合はどうすればいいですか?
A. 自社の事例・実際の取り組みで得た知見・独自の視点での比較整理など、「自社だからこそ書けること」を一次情報として形にします。他サイトの受け売りを並べるだけでは差別化になりません。数値を使う場合は、必ず出典を添え、あいまいな数字を断定しないよう注意します。
Q. Perplexity対策とAI検索対策は別物ですか?
A. 別物ではなく、Perplexity対策はAI検索対策(AIO・GEO・LLMO)の一分野です。ChatGPTやGoogle AI Overviewsなど他のAI検索と共通する土台を固めたうえで、Perplexity固有の「鮮度」「要点の明快さ」を補う、という位置づけで取り組むのが効率的です。