AI検索対策のやり方|構造化データ・llms.txt・一次情報の実装チェックリスト
「AI検索対策をやった方がいいのはわかったが、結局何を・どの順番で実装すればいいのか」——そう感じている事業者・広告運用担当の方は多いはずです。概念の解説は増えましたが、手を動かすレベルの具体策になると、情報が散らばっていて迷いやすいのが実情です。この記事では、ChatGPTやGoogleのAI回答、Perplexityといった生成AIに自社情報を見つけ・引用してもらうための対策を、「そのまま実装チェックとして使える7項目」に分解して整理します。
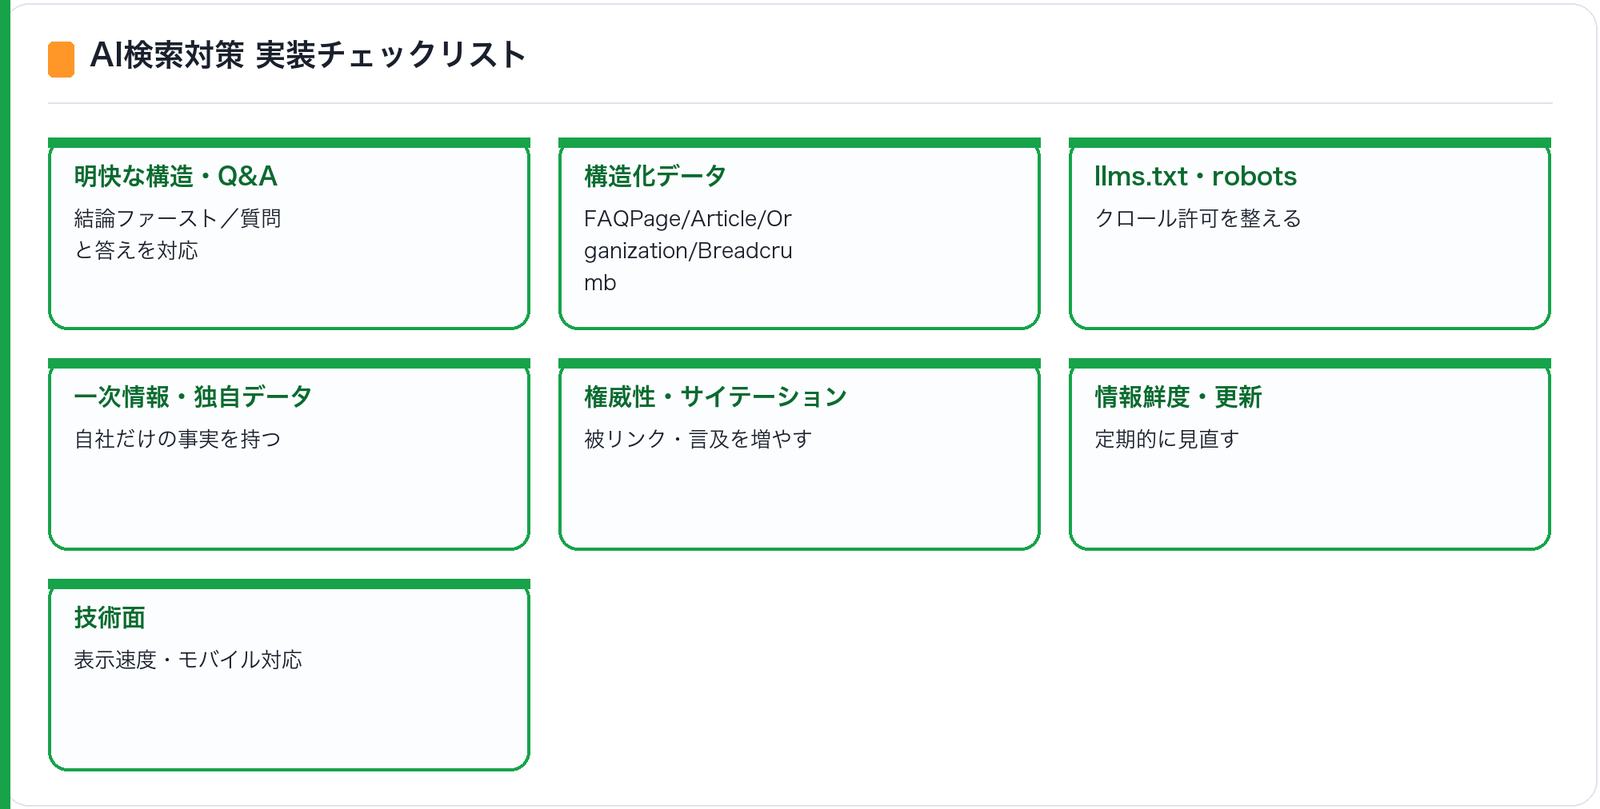
先に結論です。AI検索対策のやり方は、(1)結論ファーストの明快な構造 (2)構造化データ (3)クロール許可とllms.txt (4)一次情報 (5)権威性・サイテーション (6)情報鮮度 (7)技術面——この7つを順に実装していくことに尽きます。特別な裏技はありません。AIが読みやすく、引用の根拠にしやすい形にページを整える——この一点に向けて、できる施策を積み上げるのが正攻法です。
この記事のポイント
- AI検索対策は7つの実装項目に分解できる。上から順に着手すればよい
- 土台は「本文の中身」。構造化データやllms.txtは中身を補助する仕組みにすぎない
- llms.txtは標準化が進む「提案段階」の仕組み。過度な期待は禁物だが、低コストなので用意しておく価値はある
- まず着手すべきは「結論ファーストの書き方」と「クロールを止めていないかの確認」の2つ
AI検索対策の全体像を「実装」の観点で分解する
AI検索対策は、AIO(AI Optimization)やGEO(Generative Engine Optimization)、LLMO(Large Language Model Optimization)など複数の呼び名で語られますが、実務ではほぼ同じ方向を指します。すなわち、生成AIの回答のなかで自社の情報が参照・引用され、そこから認知や指名検索、問い合わせにつながる状態を目指す取り組みです。用語の整理はLLMOとは?AIに引用される最適化と従来SEOとの違いで詳しく解説していますので、概念から押さえたい方はあわせてご覧ください。
実装の観点で見ると、やるべきことは大きく「中身(コンテンツ)を整える」と「器(技術・設定)を整える」の2層に分かれます。順番が大切で、中身が薄いままタグや設定だけ整えても引用はされません。構造化データやllms.txtは、あくまで良質な中身をAIに正しく伝えるための補助輪だと捉えてください。実際、国内外の解説でも「構造化データは意味を機械に伝える補助情報であり、本文に書いていない結論や比較条件を代わりに伝えることはできない」と繰り返し指摘されています。
まずは全体像をチェックリストで把握する
この記事で解説する7項目を、先に一覧にまとめます。詳細はこの後の見出しで1つずつ「なぜ効くか」「最初の一歩」を添えて掘り下げますが、まずは自社サイトが今どこまでできているかを、ざっと照らし合わせてみてください。
| 実装項目 | 目的(なぜ効くか) | 難易度 |
|---|---|---|
| (1)明快な構造・結論提示 | AIが答えを抜き出しやすくする | 低 |
| (2)構造化データ | ページの意味を機械に正確に伝える | 中 |
| (3)クロール許可・llms.txt | そもそもAIに読んでもらえる状態を作る | 低〜中 |
| (4)一次情報・独自データ | 引用する価値のある固有の情報を持つ | 中〜高 |
| (5)権威性・サイテーション | 信頼できる発信元だとAIに判断させる | 中〜高 |
| (6)情報鮮度・更新 | 最新の問いに対して選ばれやすくする | 低 |
| (7)技術面(速度・モバイル) | クロールと読み取りの障害をなくす | 中 |
難易度「低」の(1)(3)(6)は、今日からでも着手できます。まずはここから手をつけ、(2)(4)(5)(7)へ広げていくのが現実的な進め方です。全項目を一度に完璧に仕上げようとすると手が止まりがちなので、「低コストで効く項目から1つずつ潰していく」という進め方を強くおすすめします。チェックリストは、着手済み・未着手を自社で管理する台帳としても使ってください。
なお、ここでいう「AI検索」には、ChatGPTのような対話型AIに直接質問するケース、GoogleのAI Overviews(AIによる回答表示)のように検索結果の中にAI回答が現れるケース、Perplexityのように出典を明示して回答する検索特化型など、いくつかの形があります。細かな挙動は各サービスで異なりますが、「AIが読みやすく、引用の根拠にしやすいページを用意する」という対策の方向性は共通しています。だからこそ、個別のサービスを追いかけるより、この7項目のような普遍的な土台を固める方が、結果的に費用対効果が高くなります。
実装チェックリスト(1)|明快な構造と結論ファースト・Q&A形式
最初に整えるべきは、タグでも設定でもなく「書き方」そのものです。生成AIは、ページから質問への答えになりそうな部分を抜き出して回答を組み立てます。したがって、答えがどこに書いてあるか分かりにくいページは、中身が良くても引用されにくくなります。
なぜ効くか
AIは、問いに対する端的な答えを探します。結論が冒頭にあり、見出しが問いの形になっていて、1つの見出しに1つの論点がまとまっているページは、AIにとって「抜き出しやすい」構造です。逆に、結論が最後までお預けになる文章や、1つの見出しに論点が詰め込まれた文章は、答えの箇所を特定しにくく、候補から外れやすくなります。これは従来のSEOで重視されてきた「検索意図に的確に答える」という考え方の延長線上にあります。
最初の一歩
各見出しの直後に、その見出しの問いに対する結論を1〜2文で先に書くことから始めてください。たとえば「AI検索対策に費用はかかる?」という見出しなら、冒頭で「基本的な実装は自社で無料でできます。外注する場合の目安は……」と結論から入ります。さらに、よくある質問をページ末尾にQ&A形式でまとめると、AIが一問一答を抜き出しやすくなります。箇条書きや表も、情報の構造が明確になるため有効です。
実装チェックリスト(2)|構造化データ(FAQPage・Article・Organization・Breadcrumb)
構造化データは、ページの内容が「何についての、どういう種類の情報か」を機械が理解できる形式で添える仕組みです。形式は、Googleが推奨するJSON-LD(スクリプトタグ内にまとめて記述する方式)が実装・管理ともに扱いやすく、見た目にも影響しないため第一候補になります。語彙(ボキャブラリ)はschema.orgの定義に従います。
なぜ効くか
構造化データそのものが順位や引用を直接押し上げる「魔法の施策」ではありません。ただし、著者・運営者・公開日・FAQなどの要素を機械可読な形で明示しておくと、AIがページの意味を誤解なく取り込みやすくなります。重要なのは、構造化データの内容と本文の内容が一致していることです。本文に書いていないことを構造化データにだけ書いても意味がなく、場合によっては不正確な情報とみなされる恐れもあります。
最初の一歩
まずは実装の優先度が高い4つの型から着手します。
| 型(type) | 役割 | どこに置くか |
|---|---|---|
| Organization | 運営会社・発信元を明示する | トップページなどサイト共通 |
| Article | 記事の著者・公開/更新日・見出しを示す | 各記事ページ |
| FAQPage | 一問一答を構造的に伝える | FAQを設けた記事ページ |
| BreadcrumbList | サイト内の位置関係を示す | 下層の各ページ |
FAQPageの記述イメージは、たとえば次のような形です(実際の質問・回答は本文のFAQと一致させます)。
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "FAQPage",
  "mainEntity": [{
    "@type": "Question",
    "name": "AI検索対策に費用はかかりますか?",
    "acceptedAnswer": {
      "@type": "Answer",
      "text": "基本的な実装は自社で無料でできます。"
    }
  }]
}
</script>WordPressなどのCMSを使っている場合は、プラグインや構造化データの設定機能で非エンジニアでも設定できることが多いので、まずは自社環境でどの型が出力できるかを確認するとよいでしょう。実装後は、記述の文法ミスがないかを公式のテストツールで検証する習慣をつけてください。
実装チェックリスト(3)|llms.txt・robots.txtとクロール許可
どれだけ中身が良くても、AIのクローラーがそのページを取得できなければ引用のしようがありません。意外な落とし穴として、ホスティングやCMSの初期設定で、AIクローラーが知らないうちにブロックされているケースがあります。ここは「新しく許可を足す」よりも「意図せず止めていないかを確認する」観点が重要です。
なぜ効くか
生成AIのクローラーには、学習用(GPTBot、ClaudeBot、Google-Extended、CCBotなど)と、検索・回答時に参照する用途(OAI-SearchBot、PerplexityBot、ChatGPT-Userなど)があり、役割が分かれています。AI検索で情報源として見つけてほしい公開ページでは、検索・参照用のクローラーを止めないことが基本です。学習利用だけを避けたい場合は、学習用のクローラーだけを個別に拒否する、といった切り分けができます。なお、robots.txtはあくまで「守ることを前提とした要請」であり、強制力はない点には注意してください。非公開にしたい情報は、認証やアクセス制御で別途守る必要があります。
最初の一歩
まず自社のrobots.txtを開き、主要なAIクローラーを一括でDisallowしていないかを確認します。可視性を重視するなら、参照されたいクローラーに対して取得を妨げない設定にします。
# 例:検索・参照用クローラーの取得を妨げない
User-agent: OAI-SearchBot
Allow: /

User-agent: PerplexityBot
Allow: /

# すべてのクローラー向けの基本設定
User-agent: *
Allow: /各社のユーザーエージェント名は変わることがあるため、実際に設定する際は各AI事業者の公式ドキュメントで最新のクローラー名を確認してください。
llms.txtは「提案段階」の仕組みとして用意しておく
あわせて検討したいのがllms.txtです。これはサイトのルートに置き、重要なページをMarkdownで厳選して案内するファイルで、LLMがHTML全体を解析せずに主要コンテンツを読めるようにする狙いがあります。robots.txtやsitemap.xmlに似ていますが、役割は異なり、llms.txtは「厳選された案内図」に近いものです。2024年にJeremy Howard氏らによって提案され、仕様はllmstxt.orgで公開されています。
ただし重要な前提として、llms.txtは正式な標準として確立したものではなく、標準化が進む「提案段階」の仕組みです。主要AIプラットフォームでの採用は限定的で、Googleは自社のAIシステムがこのファイルを使っていないとする立場を示しています。したがって「llms.txtを置けばAIに引用される」といった過度な期待は禁物です。一方で、用意するコスト自体は低く、構成がシンプルなサイトでは主要ページの案内として整理に役立つ面もあります。「効果を断定せず、低コストの先行投資として置いておく」くらいの温度感で扱うのが、2026年時点では妥当な判断です。普及状況は変わり得るので、最新の動向は公式情報で確認しましょう。
実装チェックリスト(4)|一次情報・独自データを持つ
ここからは「中身の価値」を高める項目です。AIに引用されるページの共通点は、そのサイトにしか書かれていない固有の情報を持っていることです。どこかで読んだ内容を言い換えただけのページは、AIがわざわざ出典として選ぶ理由がありません。
なぜ効くか
生成AIは回答の根拠として、独自性と信頼性のある情報源を参照しようとします。一次情報とは、大規模な調査データだけを指すものではありません。自社の運用で得た条件・制約・比較基準・実際の観察といった、現場の固有情報も立派な一次情報です。たとえば「この条件ではこうなった」「実務ではこの順番で進めると詰まりにくい」といった記述は、他サイトが真似しにくく、引用される価値を生みます。
最初の一歩
まず、自社が持っている「言える範囲の事実」を棚卸ししてみてください。実際の制作・運用で分かった傾向、よくある失敗とその回避策、判断の分岐基準などです。これらを、数値や成果を誇張せず、事実として書き出すだけでも独自性は大きく高まります。私たちの運用でも、LPの訴求を広告で素早く検証し、勝った切り口のデータをコンテンツに反映する——という進め方は、他では得にくい固有の知見になっています。検証して得た一次データを、そのまま記事の根拠として活かす発想がおすすめです。
実装チェックリスト(5)|権威性・サイテーション・被リンク
同じことが書かれていても、「誰が・どのサイトで」書いているかによって、AIが引用元として選ぶかどうかは変わってきます。発信元の信頼性を示すシグナルを整えることが、この項目のテーマです。
なぜ効くか
GoogleのE-E-A-T(経験・専門性・権威性・信頼性)は、もともと検索品質評価者向けの指針として位置づけられるものですが、信頼性のシグナルは従来SEOだけでなくAI検索の引用元選定でも参照される傾向が強まっている、という見方が国内外で示されています。著者情報がない記事、運営者が不明なサイト、情報ソースが示されていないコンテンツは、AIが信頼性を判断しにくく、引用されにくいと指摘されています。また、サイテーション(他サイトやSNSで自社名・ブランド名が言及されること)や被リンクは、「第三者から参照されている」という信頼の裏付けとして働きます。
最初の一歩
低コストで効果的なのは、次の3点から着手することです。
- 著者・運営者情報の明記:記事に著者名や経歴、運営会社情報を添える。Organization/Articleの構造化データとも連動させる
- 一次情報へのリンク:主張の根拠となる公式情報・公的データへ、本文からリンクする(孫引きではなく元の出典へ)
- 言及されやすい固有名詞を持つ:サービス名・独自の考え方に名前をつけ、SNSや他メディアで言及されやすくする
いきなり大量の被リンクを狙うより、「正確な出典を示し、発信元を明確にする」という基本を固める方が、再現性が高く安全です。
実装チェックリスト(6)|情報鮮度・更新
AI検索では、「最新の」「2026年版の」といった鮮度を含む問いが頻繁に投げられます。情報が古いまま放置されたページは、こうした問いの答えとして選ばれにくくなります。
なぜ効くか
特にAI検索対策のような動きの速い分野では、仕様や各社の対応状況が頻繁に変わります。古い情報を載せ続けると、内容が実態とずれて信頼性を損ない、引用の対象から外れやすくなります。逆に、更新日が明確で内容が最新に保たれているページは、鮮度を求める問いに対して選ばれやすくなります。
最初の一歩
公開して終わりにせず、更新日を記事に明示し、構造化データのdateModifiedも実際の更新に合わせて更新することから始めます。そのうえで、主要記事は定期的に見直すサイクルを決めておきましょう。更新すべき記事の優先順位づけは、検索パフォーマンスのデータを見て判断するのが効率的です。AI時代の効果測定の考え方は、AI検索対策の効果測定・KPIで詳しく整理しています。
実装チェックリスト(7)|技術面(表示速度・モバイル対応)
最後は、クロールと読み取りの障害をなくす技術面です。中身と信頼性が整っていても、ページが重かったり、クローラーがコンテンツを取得しにくい作りだと、評価の土台を損ないます。
なぜ効くか
表示が極端に遅いページや、コンテンツがスクリプトでしか描画されず取得しづらいページは、クローラーが内容を正しく読み取れないことがあります。読み取れなければ、構造化データも本文も伝わりません。モバイルでの見やすさも、ユーザー体験と評価の両面で重要です。これらは従来のSEO・Webの基本と重なる部分が多く、AI検索対策においても前提として効いてきます。
最初の一歩
Google PageSpeed Insightsなどで表示速度を診断し、重い画像の軽量化や不要スクリプトの削減から着手します。あわせて、スマートフォンで本文がきちんと読めるか、主要なテキストが画像化されていないか(=テキストとして取得できるか)を確認してください。本文が画像内の文字になっていると、AIはその内容を読み取れません。重要な情報は必ずテキストで書く——これは見落とされがちですが基本の一歩です。
AI検索対策でよくある失敗
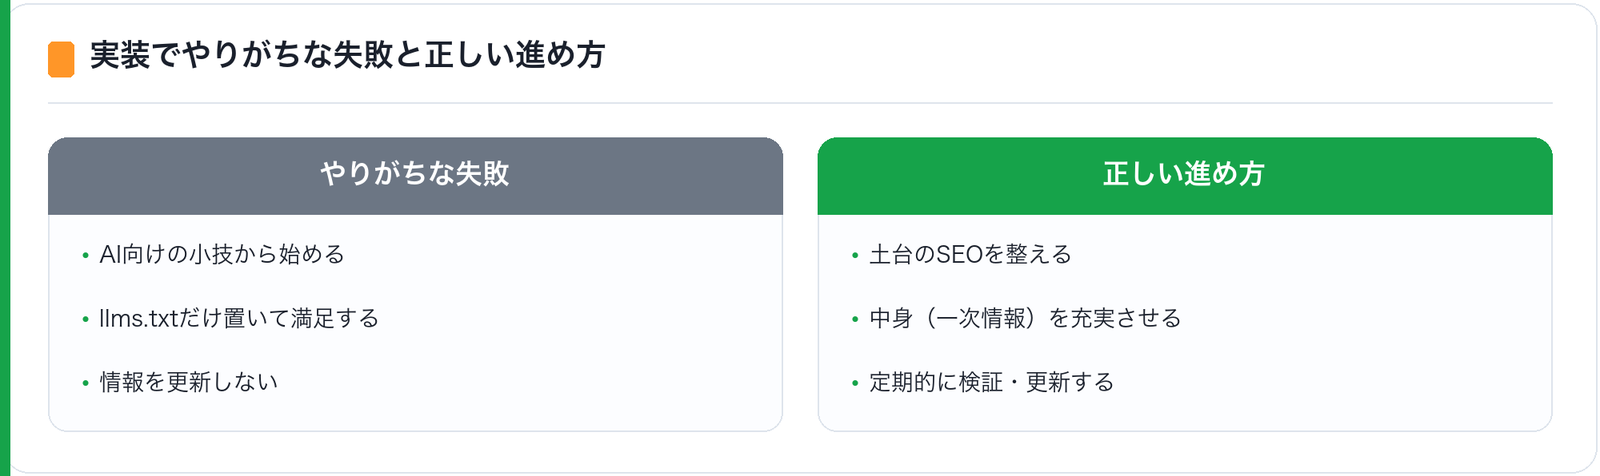
最後に、実装時に陥りがちな失敗を整理します。どれも「順番」と「期待値」を取り違えることから起こります。
失敗1:中身が薄いまま、タグや設定だけ整える
構造化データやllms.txtを先に整えても、本文に引用する価値がなければ引用はされません。構造化データは本文の内容を補助する仕組みであり、本文に書いていない結論を代わりに伝えることはできない、という原則を忘れないでください。まず中身、次に器です。
失敗2:llms.txtに過度な期待をする
llms.txtは標準化が進む提案段階の仕組みで、主要AIの採用は限定的です。「置けば引用される」ものではありません。低コストの先行投資として用意するのはよいですが、効果を断定して主軸に据えるのは避けましょう。
失敗3:AIクローラーを一括で拒否してしまう
学習利用を避けたい一心で、検索・参照用のクローラーまで一括でブロックすると、AI検索で自社の公式ページが見つかりにくくなる可能性があります。学習用と参照用を切り分けて設定するのが安全です。
失敗4:出典のない主張・数値を載せる
根拠のない成果保証や、出典の曖昧な数値は、信頼性を損ないます。AIは情報ソースが明示されていないコンテンツの信頼性を判断しにくく、かえって引用されにくくなります。事実と推測を分け、出典を示す姿勢が結果的に近道です。
よくある質問
Q. AI検索対策のやり方として、まず何から始めればいいですか?
A. 難易度の低い「(1)結論ファーストの書き方」と「(3)AIクローラーを止めていないかの確認」の2つからがおすすめです。どちらも費用をかけずに着手でき、効果の土台になります。そのうえで構造化データや一次情報の拡充へ進めます。
Q. 構造化データはどの型から実装すべきですか?
A. Organization(運営元)、Article(記事情報)、FAQPage(一問一答)、BreadcrumbList(階層)の4つが優先度の高い型です。JSON-LD形式で記述し、必ず本文の内容と一致させてください。本文にない情報を構造化データにだけ書くのは逆効果です。
Q. llms.txtは必ず設置した方がいいですか?
A. 必須ではありません。llms.txtは標準化が進む提案段階の仕組みで、主要AIの採用は限定的です。ただし設置コストは低いため、「効果を断定せず、低コストの先行投資として置いておく」程度の位置づけで用意する分には価値があります。
Q. AIに学習されたくないページは、どう設定すればいいですか?
A. robots.txtで学習用クローラー(GPTBot、Google-Extendedなど)だけを個別に拒否する切り分けが基本です。検索・参照用まで一括で止めると、AI検索での可視性を失う恐れがあります。なお確実に守りたい非公開情報は、認証やアクセス制御で別途保護してください。
Q. 構造化データを入れればAI検索で上位・引用されますか?
A. それだけで引用されるわけではありません。構造化データはページの意味を機械に正しく伝える補助であり、順位や引用を直接押し上げる魔法の施策ではありません。土台となる本文の質と独自性、発信元の信頼性があってはじめて効いてきます。
Q. 従来のSEOとAI検索対策は、別々にやる必要がありますか?
A. 多くは共通します。結論ファーストの構造、一次情報、信頼性、技術面の整備は、従来SEOとAI検索対策の双方で効きます。まったく別物として二重にやるというより、既存のSEOの考え方を土台に、構造化データやクロール設定などAI向けの観点を足していくイメージが実態に合います。
まとめ:AI検索対策は「中身を整えてから器を整える」
AI検索対策のやり方は、7つの実装項目を順に積み上げることに尽きます。土台は本文の質と独自性であり、構造化データやllms.txtはそれを正しく伝える補助輪です。特にllms.txtは標準化が進む提案段階の仕組みなので、過度な期待はせず、低コストの先行投資として扱うのが賢明です。まずは費用のかからない「結論ファーストの書き方」と「クロール設定の確認」から着手し、順に広げていきましょう。AI検索対策全体の進め方や基礎から確認したい方は、柱となるAI検索対策とは?AIO・GEO・LLMOの基礎と今すぐ始める進め方もあわせてご覧ください。
そして、この記事で繰り返し触れた「一次情報を持つ」「検証して得た知見をコンテンツに活かす」という発想は、広告運用とも相性が良いものです。訴求をLPで素早く検証し、勝った切り口のデータを記事やコンテンツに展開していけば、AIに引用される独自性のある情報が自然と積み上がっていきます。
※ 本記事は2026年11月時点の一般的な解説であり、特定の順位や成果を保証するものではありません。AI検索やllms.txtの仕様・各社の対応状況は変動するため、実装時には各AI事業者やschema.orgなどの公式情報で最新の内容をご確認ください。